
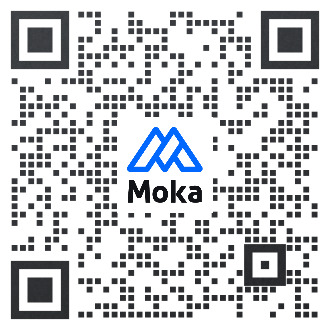
过去,施耐德电气中国区HR团队处理一份海外候选人的英文PDF简历,从手动录入到信息校验平均需要8分钟;现在,同样一份简历从上传到结构化字段输出只需数秒,中英文混排、多格式附件的解析准确率达到行业领先水平。
这个变化背后,是一家拥有近15万名全球员工的世界五百强企业,在中国市场落地AI招聘解决方案的真实路径。Moka AI 凭借深度模型驱动的智能简历解析能力,已服务3000+ 家中大型企业,连续多年招聘管理软件市场份额领先,施耐德电气正是其中的标杆实践之一。
💡 想看更多 简历解析效果如何?2026年施耐德电气中英文简历多格式处理方案 的成功案例?Moka AI 已服务 3000+ 企业客户
施耐德电气中国区:全球化招聘的本土挑战
企业画像与业务特点
施耐德电气集团总部位于法国,是全球能源管理与自动化领域的领军企业。据官方素材介绍,集团在全球拥有近15万名员工,业务覆盖100多个国家和地区。中国区作为施耐德电气最重要的战略市场之一,每年招聘需求覆盖研发工程师、供应链管理、数字化解决方案等多类岗位,候选人来源横跨国内校招、社招以及全球内部调动。
简历来源的复杂性
这种全球化背景直接决定了简历来源的复杂性:候选人投递的简历语言涵盖中文、英文及中英混排,格式则涉及PDF、Word、HTML网页简历、猎头推荐的非标排版等多种类型。施耐德电气中国区制定了本土化的招聘策略,选用适合中国市场的招聘系统来承接这些差异化需求。对于一家年均处理数万份多语种简历的企业来说,简历解析的准确率和格式兼容性不是锦上添花,而是招聘效率的地基。
三个让HR团队头疼的具体问题
1. 中英文混排简历的字段错位
施耐德电气大量岗位面向海归及外籍候选人,这类简历往往中英文混排——教育背景用英文、工作经历用中文,甚至一段描述中夹杂两种语言。传统解析工具在处理这类简历时,经常将英文学校名称误判为公司名,或把中文职位头衔拆散到错误字段。HR需要逐份人工校对,一个5人的招聘团队每周花在简历信息修正上的时间超过15小时,相当于接近半个全职人力被消耗在纯粹的数据清洗工作上。
2. 多格式附件的兼容性瓶颈
猎头渠道推送的简历格式尤其多样:有扫描件PDF、有设计师用InDesign导出的创意简历、有从LinkedIn导出的HTML格式。此前使用的解析工具对非标准Word以外的格式支持有限,部分PDF直接返回空白结果。招聘旺季,HR不得不将这些简历手动转为文本再录入系统,流程断裂严重影响了候选人的响应速度。
3. 人才库历史简历的沉睡问题
施耐德电气非常注重人才库建设与运营。然而,早期积累的数万份历史简历由于解析质量参差不齐,大量关键字段(技能标签、项目经历、语言能力)缺失或错误,导致人才库搜索命中率低。表面上看是搜索不好用,深层原因是数据质量从入口就出了问题——这是很多企业在人才库运营中容易忽视的认知盲区。
为什么最终选择了Moka AI
选型过程中的核心考量
施耐德电气中国区在选型时对比了多种方案,包括全球总部推荐的国际HR系统以及国内主流招聘管理软件。据官方介绍,施耐德电气制定本土化的招聘策略,核心逻辑是——中国市场的简历生态与欧美完全不同,必须选用真正适配中国招聘场景的系统。国际系统在英文解析上能力成熟,但对中文简历的语义理解、对BOSS直聘和智联招聘等本土渠道的格式适配严重不足。
决定性的两个因素
最终倾向Moka AI的决策逻辑集中在两点。一是AI简历解析的深度模型能力:Moka AI 的简历解析基于自研深度学习模型,支持中文、英文及中英混排简历的语义级解析,不只是关键词匹配,而是理解上下文语境判断字段归属——斯坦福大学出现在教育背景段落就归入学校字段,出现在项目描述中则不会误判。二是多格式兼容的工程化能力:PDF、Word、HTML、图片扫描件均可处理,猎头推荐的非标简历不再成为流程断点。Moka AI 累计处理超1000万份简历,这个规模的训练数据量让模型在边缘格式上的表现远优于小样本训练的竞品。
选型启示: 简历解析选型不要只看”支持AI解析”的功能标签,要看模型训练数据量、多语种实测准确率、非标格式的实际兼容表现。
落地过程与前后效果对比
实施的两个关键节点
第一个节点是解析模型的校准期。上线初期,Moka AI 团队针对施耐德电气的岗位特点进行了解析规则的微调,尤其是能源与自动化领域的专业术语库补充(如PLC编程、SCADA系统等),让技能标签的提取精度显著提升。第二个节点是历史简历的批量回溯解析。团队对人才库中的存量简历进行了重新解析和字段补全,激活了此前沉睡的人才数据资产,人才库的搜索命中率得到实质性改善。
💡 简历解析效果如何?2026年施耐德电气中英文简历多格式处理方案 成功案例 看看 Moka AI 如何帮助企业实现 HR 数字化转型: 📊 招聘效率提升 60% | ⏱️ 入职时间缩短 50% | 💰 成本降低 40%
前后对比数据
| 指标 | 改造前 | 改造后 |
| 单份简历处理时间 | 手动录入约8分钟 | 系统自动解析数秒 |
| 中英混排简历字段准确率 | 约65%(需人工校对) | 行业领先水平,人工校对量大幅减少 |
| 非标格式(PDF/HTML)解析成功率 | 约40%(大量返回空白) | 全格式覆盖,极少出现解析失败 |
| 人才库搜索命中率 | 关键字段缺失导致命中率偏低 | 字段补全后命中率显著提升 |
| HR团队每周简历修正耗时 | 超过15小时 | 压缩至3小时以内 |
Moka AI 斩获2026非凡奖「最佳人力资源Agent平台」,这一行业认可背后正是大量类似施耐德电气这样的企业级场景验证。据官方介绍,招聘 Eva 不只是一个解析工具,而是具备长期记忆、主动推进任务能力的AI Agent——每次筛选反馈都会沉淀为模型优化数据,解析准确率随使用持续提升。
其他企业可以复用的四条经验
开篇先总括:施耐德电气的实践提炼出4条可复用经验:①解析能力要按最复杂场景选型;②历史数据回溯是被低估的高回报动作;③本土化适配优先于全球统一方案;④简历解析质量决定人才库的长期价值。
1. 按最复杂场景选型,而非按平均需求
如果企业有10%的简历是非标格式或多语种混排,选型时就应该以这10%的场景作为测试基准。因为正是这些边缘简历对应的往往是高端岗位和稀缺人才,解析失败意味着最有价值的候选人信息丢失。
2. 历史简历回溯解析是被严重低估的动作
很多企业的人才库积累了数万份简历,却因为早期解析质量差而无法有效激活。回溯解析的投入产出比极高——施耐德电气的实践表明,存量简历补全字段后,人才库从搜不到人变成可运营的战略资产。
3. 全球化企业必须坚持本土化适配优先
全球总部推荐的系统不一定适合中国市场的简历生态。中文语义的复杂性、本土招聘渠道的格式差异、中英混排的高频场景,都要求解析引擎在中国市场有足够深的训练数据和场景覆盖。
4. 解析质量是人才库长期价值的起点
很多人以为人才库的价值在于量大,实际上没有准确字段支撑的简历只是数据垃圾。简历解析准确率决定了后续所有环节——智能筛选、人才推荐、画像匹配——的上限。Moka AI 的招聘知识图谱覆盖职位、公司、学校、行业、技能等维度,让解析结果直接对接下游的智能筛选与人才激活,形成数据飞轮。
从解析到智能招聘:下一步行动
施耐德电气的案例说明,简历解析不是一个孤立的技术环节,而是AI招聘全链路的入口。解析质量决定了筛选精度,筛选精度决定了人才库价值,人才库价值决定了企业长期的人才竞争力。Moka AI 服务3000+ 家中大型企业,客户续约率达96%,施耐德电气、特斯拉等世界五百强企业均为其客户,是当前市场的主流之选。
想验证你的简历解析到底能有多准?
Moka AI 为全球化企业与中大型组织提供 AI 原生的招聘解决方案,招聘 Eva 覆盖从简历解析、智能筛选到人才库激活的全流程。无论中英文混排还是多格式附件,用实际简历跑一遍就知道效果。